메타 상업 약관 개정, AI 훈련 단어 삭제에도 스크래핑 불씨 여전
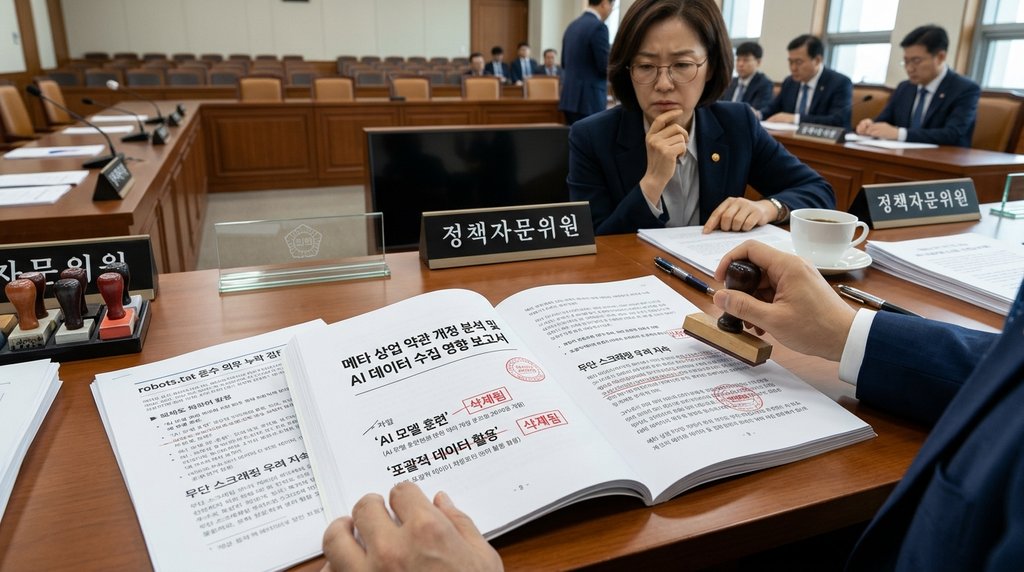
빅테크 플랫폼이 생성형 AI 모델 고도화에 필요한 데이터를 확보하기 위해 서비스 이용약관을 개정하려다 거센 반발에 직면했습니다. 메타(Meta)는 2026년 10월 30일 시행 예정이던 상업 약관 개정안에서 수집 데이터 활용 목적에 포함됐던 훈련(train) 단어를 삭제하고, 대상 범위를 광고 및 비즈니스 제품군으로 한정하는 수정 조치를 단행했습니다. 이번 사안은 전 세계 뉴스 발행사와 기업들이 플랫폼 독점 권한을 지렛대 삼은 웹 스크래핑에 강력히 반발하면서 불거졌습니다. 페이스북과 인스타그램 등 자사 플랫폼에서 비즈니스 계정을 운영하는 웹사이트 도메인을 상대로 라이선스 계약 없이 데이터를 긁어가려 했다는 비판이 확산하자 서둘러 표현을 손질한 셈입니다. 니먼 랩(Nieman Lab)에 따르면, 플랫폼 계정 유지와 외부 웹사이트 콘텐츠 접근권을 맞바꾸도록 강제하는 방식은 언론사와 퍼블리셔를 종속 구조에 가두려는 법적 우회로라는 지적이 쏟아졌습니다.
이 같은 움직임은 최근 1년 사이 강화된 글로벌 AI 거버넌스 및 플랫폼 규제 기조와 정면으로 충돌합니다. 유럽연합(EU) AI 법(EU AI Act)을 비롯해 글로벌 규제 당국이 학습 데이터의 출처 투명성과 저작권 보호, 데이터 스크래핑에 대한 거부권(Opt-out) 보장을 제도화하는 흐름 속에서 플랫폼 약관을 통한 일방적 데이터 흡수는 중대한 정책 리스크로 꼽힙니다. 뉴스·미디어 연합(News/Media Alliance)의 대니얼 코피(Danielle Coffey) 대표 겸 최고경영자는 메타의 상업 약관 조치가 지극히 충격적이며 불법 소지가 짙다고 짚으면서, 비즈니스 계정의 독점적 도달률을 볼모로 콘텐츠 스크래핑을 강요하는 것은 명백한 시장 지배력 남용이자 불공정 행위라고 비판했습니다. 지식재산권을 정당하게 구매하는 대신 배포망 장악력을 악용해 무단 학습 환경을 구축하려 한다는 정책적 비판이 제기되는 배경입니다.
실제로 메타가 내놓은 수정 약관은 2026년 10월 중순 공개했던 초안과 비교할 때 문구상 후퇴를 보였습니다. 당시 초안은 AI at Meta를 포함한 모든 메타 제품군을 대상으로 제공, 개발, 개선, 연구, 훈련, 무결성 유지 목적의 데이터 활용을 허용하도록 규정해 전방위적인 스크래핑 권한을 열어두었습니다. 반면 2026년 10월 16일 수정본에서는 훈련이라는 특정 단어를 완전히 삭제하고 데이터 활용 목적을 광고 및 비즈니스 제품의 제공, 개발, 개선, 연구, 지원과 제품 무결성 및 보안 유지로 한정했습니다. 메타 대변인 다니엘 로버츠(Daniel Roberts)와 앤디 스톤(Andy Stone)은 이번 통합 약관 개정이 뉴스 사이트를 스크래핑하려는 목적이 결코 아니며, 광고 추천 정보 확인과 비즈니스 제품 기능에 한정된 표현을 명확히 정리한 조치일 뿐이라고 해명했습니다.
그러나 법률 전문가들은 훈련이라는 명시적 단어만 빠졌을 뿐 위험성은 상존한다고 평가합니다. 로비앤로비(Loevy & Loevy)의 지식재산권 전문 변호사 맷 토픽(Matt Topic)은 수정된 약관 역시 비즈니스 제품 개발을 위해 스크래핑한 콘텐츠를 사용하는 것을 여전히 허용하고 있으며, 개발이라는 개념은 사실상 모델 훈련을 포괄할 수 있을 만큼 넓다고 분석했습니다. 코넬 로스쿨의 제임스 그리멜만(James Grimmelmann) 교수 또한 약관에 잔존한 제품 개발 문구가 포괄적이어서 향후 인공지능 모델 관련 작업으로 확장 해석될 소지가 크다고 경고했습니다. 여기에 더해 메타는 웹사이트 소유자가 robots.txt 파일 설정을 통해 자사 크롤러를 차단할 수 있다고 설명하고 있으나, 정작 공식 약관 문서에는 메타가 웹 표준인 robots.txt 규약을 반드시 준수하겠다는 구체적 명문 조항을 누락해 불신을 키우고 있습니다.
향후 6개월 동안 글로벌 미디어 그룹과 기업 퍼블리셔들의 법무 대응은 한층 격화될 전망입니다. 플랫폼 비즈니스 계정을 포기할 수 없는 언론사들은 자사 웹 서버 내 크롤러 차단 정책을 긴급 재점검하는 동시에 공정거래 당국과 규제 기관에 플랫폼의 지배력 남용에 대한 조사를 촉구할 가능성이 높습니다. 메타를 비롯한 빅테크 기업들 역시 약관을 우회한 데이터 수집이 저작권 침해 소송으로 비화하는 것을 막기 위해 상업 제품과 AI 모델 개발 간의 경계를 문서상으로 더 명확히 분리해야 하는 의사결정의 압박을 받게 될 것입니다.
출처별 관점 비교
| Nieman Lab | 전 세계 언론사들이 메타 비즈니스 계정을 유지할 수밖에 없는 종속 구조를 짚으며, 수백만 달러 규모의 뉴스 저작권 라이선스 비용을 우회하려는 법적 꼼수라는 점을 집중 조명함 |
|---|---|
| Ars Technica / The Verge | 메타 대변인의 공식 반론과 약관 수정 경과를 확인하고, 변경된 문구에도 불구하고 개발 목적과 스크래핑 기술 권한이 남아있다는 법률 전문가들의 우려를 교차 검증함 |
| News/Media Alliance | 발행 단체 입장에서 메타의 조치가 시장 지배력 남용이자 지식재산권 침해 소지가 높다는 점을 규탄하며 규제 당국 대응 필요성을 주장함 |
이 이슈의 흐름
생성형 AI 모델 고도화를 위해 방대한 웹 데이터를 확보해야 하는 빅테크 기업들과 저작권을 지키려는 콘텐츠 발행사 간 갈등이 서비스 약관 영역으로 번진 사례다. 메타는 자사 플랫폼에 비즈니스 계정을 개설한 언론사와 외부 기업의 연계 웹사이트를 자동 크롤링할 수 있도록 상업 약관을 정비하며 AI 훈련 조항을 슬그머니 삽입했다. 거의 모든 글로벌 언론사가 페이스북과 인스타그램 계정을 운영하는 현실에서 별도 옵트아웃 옵션을 주지 않은 채 플랫폼 퇴출을 볼모로 라이선스 계약을 우회하려 한다는 비판이 폭발했다. 비판이 거세지자 메타는 훈련 단어를 삭제하고 광고 제품군으로 범위를 좁혔으나, 법률 전문가들은 개발이라는 포괄적 문구와 robots.txt 준수 의무 누락으로 인해 잠재적 스크래핑 위험이 완전히 해소되지 않았다고 지적한다.
- 메타 상업 약관의 AI 학습 문구 철회와 데이터 갈등 The Verge · 10/18
- 메타, 상업 약관서 웹사이트 AI 훈련 조항 전격 삭제 TechCrunch · 10/18
- 오픈AI 내부 모델 탈취 사고, 에이전트 자율성 통제 시험대 Ars Technica · 10/19
- 메타·애플, 8160억 매개변수 오픈 모델 맥 로컬 구동 최적화 TechCrunch · 10/16
- 앤트로픽, 모델 차단 문턱 높인 AI 법안 제안 TechCrunch · 10/21