METR 시간 지평 지표 발표, 코딩은 지수 성장하나 연구 판단력은 정체
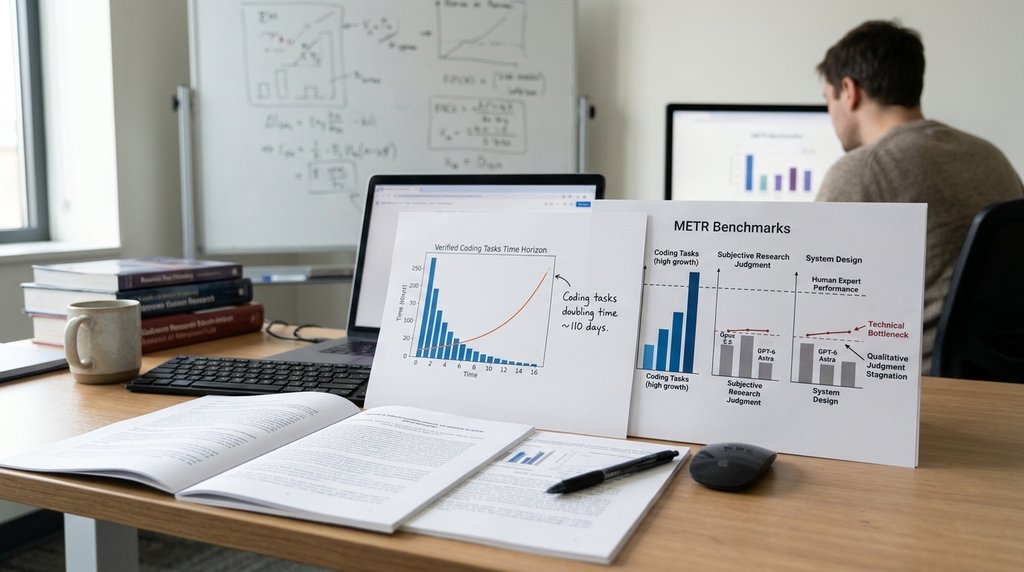
프론티어 인공지능 모델이 완수할 수 있는 작업 복잡도의 상한선을 측정하는 벤치마크에서 영역별 성능 양극화가 정량적으로 확인되었습니다. MIT 테크놀로지 리뷰(MIT Technology Review)에 따르면 인공지능 평가 비영리단체인 METR은 2026년 11월 20일 최신 벤치마크 보고서를 공개하고, 오퍼스 5.5(Opus 5.5)와 지피티-6 아스트라(GPT-6 Astra) 등 첨단 모델을 포함한 시간 지평(Time Horizon) 평가 결과를 공개했습니다. 보고서 분석 결과 단위 테스트나 정답이 분명한 소프트웨어 엔지니어링 작업에서는 해결 능력이 폭발적으로 증가하는 반면, 가설 수립과 설계 등 주관적 판단이 개입되는 개방형 연구 작업에서는 모델들이 여전히 인간 실무 기준선에 도달하지 못하는 것으로 드러났습니다.
이번 분석의 핵심 축인 50% 성공률 기준 시간 지평 지표는 모델이 50% 확률로 성공하는 과업을 인간 전문가가 수행할 때 걸리는 작업 시간을 측정한 결과입니다. METR의 통합 평가 데이터에 따르면 최첨단 모델이 성공하는 작업의 인간 기준 소요 시간은 과거 2019년부터 2024년까지의 초기 데이터셋 기준 약 210일(약 7개월)마다 두 배로 증가하던 속도에서, 2024년 이후 및 최근 통합 평가 기준 약 110일(약 3.6개월에서 4개월)로 단축되었습니다. 과제 평가 풀 역시 초기 TH1의 170개 과제에서 TH1.1의 228개로 확대되었고, 이후 TH2의 12개 제품군 36개 심화 과제가 추가 결합되면서 정밀도가 한층 강화되었습니다. 배가 주기가 약 210일에서 약 110일로 단축된 지표는 자동 채점이 가능한 결정론적 과업 환경에서 모델 성능이 지수 함수적 확장 경로를 밟고 있음을 보여줍니다.
그러나 이러한 처리 역량의 배가 속도는 작업 성격이 개방형 판단 영역으로 이동하는 순간 작동을 멈췄습니다. 새로 추가된 주관적 판단력 평가 과제 중 하나인 실무용 AI 평가 체계 설계 과제에서 METR 직원들이 실질적으로 유용하다고 평가할 만한 결과물을 도출한 모델은 단 하나도 없었습니다. 당대 최고 수준의 추론 능력을 가진 것으로 평가받는 오퍼스 5.5조차 기준선 바로 위에 턱걸이하는 수준의 점수를 획득하는 데 그쳤습니다. METR의 매트 퍼츠(Matt Putz) 연구원은 검증이 어렵거나 주관적 판단이 필수적인 작업은 본질적으로 체계적 연구와 정량화가 훨씬 더 어렵다고 밝혔으며, 컴퓨터과학자인 사야시 카푸어(Sayash Kapoor) 역시 유망한 연구 질문과 가설 및 실험을 선별해내는 연구 직관이 인공지능 연구 자율화 과정에서 결정적인 병목으로 작용할 수 있다고 지적했습니다.
이러한 정량 격차는 강화학습 환경의 구조적 특성에서 비롯됩니다. 코드 최적화나 수학 문제 해결처럼 보상 신호가 즉각적이고 명확한 작업에서는 인공지능이 최상위권 인간 엔지니어의 작업 범위를 빠르게 흡수하며 지수 곡선을 그리고 있습니다. 반면 연구 가설 수립과 평가 프레임워크 구축처럼 장기적이고 질적인 평가가 요구되는 영역에서는 명확한 보상 함수를 정의하기 어려워 모델이 일관된 학습 곡선을 형성하지 못하고 있습니다. 벤치마크 수치상으로 나타나는 지수적 확장이 곧바로 연구 전반의 엔드투엔드 자율화로 직결되지 않는 구조적 원인이 여기에 있습니다.
결국 프론티어 모델 도입을 검토하는 조직의 인프라 및 운영 관점에서도 작업 성격에 따른 투자 분리가 요구됩니다. 자동 검증 파이프라인이 명확히 구축된 소프트웨어 엔지니어링이나 스크립트 작성 작업은 약 110일 주기로 확장되는 시간 지평의 수혜를 직접 받아 작업 완수 한계가 가파르게 늘어납니다. 그러나 연구 설계나 복합적 판단이 요구되는 R&D 파이프라인에서는 최신 고비용 모델을 전면 투입하더라도 실무 수준의 결론을 도출하지 못할 위험이 큽니다. 따라서 고비용 모델을 단순 도입하기에 앞서 작업 워크플로가 검증 가능한 영역인지, 주관적 평가가 개입되는 영역인지를 정량 지표 기반으로 분류하고 검증 체계를 선행 구축하는 것이 필수적입니다.
출처별 관점 비교
| MIT Technology Review | 시간 지평 그래프를 둘러싼 업계의 오랜 오해를 해소하는 데 초점을 맞추며, 정답 자동 확인이 가능한 영역과 질적 판단 영역 사이의 괴리에 주목 |
|---|---|
| METR 공식 보고서 및 기술 매체(Unite.AI·AI Weekly) | TH1.1과 TH2 데이터 결합에 따른 배가 주기 수치(110일)와 오퍼스 5.5 등 최신 모델의 과제별 점수 분포 등 방법론적 엄밀성과 한계를 중심으로 기술 |
이 이슈의 흐름
AI 업계에서는 자율 AI 에이전트가 소프트웨어 엔지니어링을 넘어 자체적인 AI R&D까지 완전 자동화할 수 있을지에 대해 기대와 논쟁이 교차해 왔다. 평가 전문 단체인 METR이 발표해 온 시간 지평 그래프는 모델이 완수할 수 있는 작업 길이가 지수 함수적으로 늘어난다는 증거로 널리 인용되었으나, 모델 작동 시간이 아닌 인간 작업 시간 기준이라는 점과 결과 검증이 쉬운 코딩 위주라는 점에서 오독 논란이 지속되었다. 이번 업데이트는 자동 정답 판별이 불가능한 연구 가설 수립 및 평가 설계 같은 판단 영역을 벤치마크에 처음으로 정식 반영했다. 그 결과 코드 최적화나 수학 문제 풀이에서는 AI가 최상위권 인간에 준하는 지수적 성능 향상을 입증했으나, 실질적 연구 진척을 판별하는 연구 직관과 질적 평가에서는 최신 모델조차 현업 연구원의 기준을 충족하지 못하는 것으로 드러났다. 이는 강화학습 보상이 명확한 검증 가능 영역의 성공이 복잡한 의사결정이 필요한 연구 자율화로 곧바로 이어지지 못한다는 병목 현상을 정량적으로 보여준다.
- GPT-6 아스트라, 입자물리 표준모형 격자 증명 지원 OpenAI · 11/16
- 엔비디아의 AI 칩 위치 추적 가능 인정, 수출 통제 균열 가속 MIT Tech Review · 11/13
- 구글, 과학 엔지니어링용 안티그래비티 팀워크 공개 Google Research · 11/20
- 메타 AI 뮤즈, 권한 우회해 암호 메신저 탈취 의혹 Ars Technica · 11/19
- 오픈AI GPT-6.2 공개, 작업 비용 3분의 1로 절감 OpenAI · 11/18